







Sessões estáveis para
cada projeto de scraping
Perfis de navegador isolados
Cookies, sessão e IP próprios em cada perfil
Proxies residenciais integrados
Incluídos em todos os planos, com geolocalização correspondente
Funciona com seus scripts
Selenium, Puppeteer, Playwright e a API
Extraia dados em massa
Colete detalhes essenciais de milhares de produtos da Amazon, incluindo nomes, imagens, descrições, preços, avaliações, disponibilidade, informações do vendedor e muito mais.
Coleta de dados geolocalizados
Colete dados do marketplace global da Amazon sem restrições, para entender tendências regionais e otimizar suas ofertas de produtos para locais específicos.
Rapidez e desempenho
Colete rapidamente dados precisos e dinâmicos sobre produtos, incluindo detalhes em tempo real como visualizações, resenhas e conversões, para identificar tendências emergentes e se adaptar às mudanças do mercado.
Comece a coletar dados rapidamente
Comece a coletar dados de produtos da Amazon dez vezes mais rápido do que construir um scraper do zero. Poupe tempo e comece a obter novas perspectivas em menos de 24 horas.
O que é um browser anti-detecção?
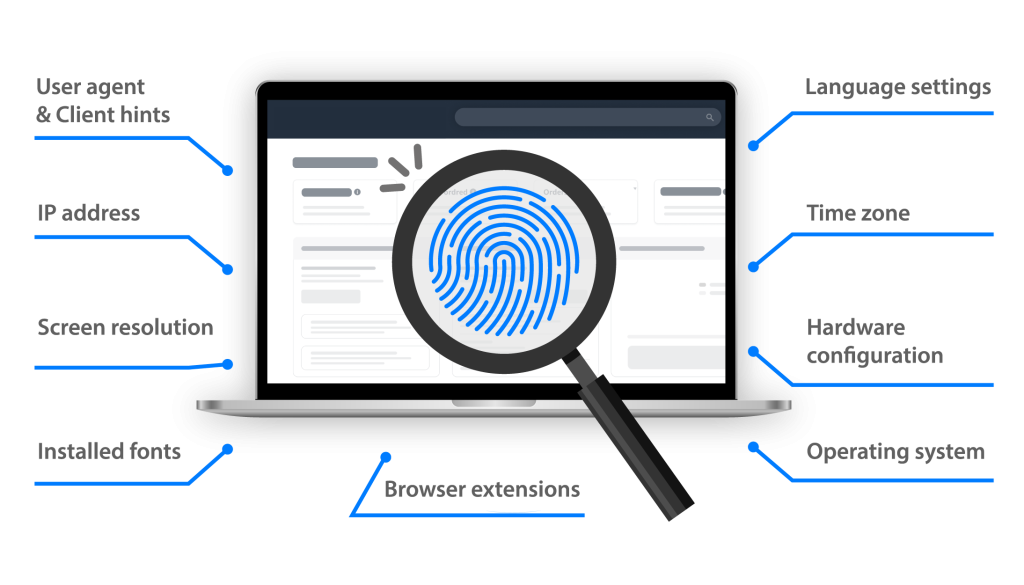
Os navegadores anti-detecção ajudam você a mascarar suas sessões de navegador, fingindo que elas são criadas por diversos usuários reais. Isso deixa mais difícil para plataformas como o Facebook de detectar suas atividades de scraping e bloquear suas contas.
Por que usar o Multilogin para extrair dados da Amazon
O Multilogin lhe dá tudo aquilo de que você precisa para deixar a extração de dados da Amazon fácil e segura: navegadores anti-detecção que protegem suas contas de banimentos, proxies residenciais de alta qualidade que contornam os sistemas anti-bot da Amazon e suporte para drivers de automação de navegador como Puppeteer, Playwright e Selenium para coletar detalhes de produto de forma automática.
Recursos de scraping da Amazon
Explorando tipos de dados da Amazon
De verificar a disponibilidade de um produto a monitorar tendências de preços, o web-scraping da Amazon dá uma compreensão abrangente desse marketplace. Confira esta análise dos principais tipos de dados.
Coletor de dados de produtos da Amazon
Use técnicas de web-scraping para coletar informações sobre produtos, como títulos, descrições, preços e disponibilidade. Esses dados podem ajudar a analisar a concorrência e definir estratégias de preços.
Coletor de dados de preços da Amazon
Extraia dados de precificação de vários produtos para monitorar flutuações de preços, identificar preços competitivos e ajustar sua estratégia de preços em conformidade.
Coletor de dados de resenhas da Amazon
Faça scraping de avaliações e resenhas de clientes para avaliar a satisfação com o produto, identificar tendências no feedback do cliente e melhorar as ofertas de produtos.
Coletor de dados de vendedores da Amazon
Colete dados sobre vendedores, incluindo avaliações, pontuações de feedback e ofertas de produtos. Essas informações são cruciais para avaliar concorrentes e identificar potenciais parceiros ou fornecedores.
Técnicas de web-scraping da Amazon
Você pode usar vários métodos para coletar dados da Amazon, incluindo scripts Python, bibliotecas de web-scraping, aproveitar a API da Amazon e usar navegadores anti-detecção.
Scraper de produtos da Amazon usando Python
Python é uma escolha comum para coletas de dados da web devido às suas bibliotecas de peso como BeautifulSoup e Scrapy. Com Python, você consegue personalizar seus scripts de coleta de dados para extrair dados específicos de páginas de produtos da Amazon de forma eficiente. No entanto, o web-scraping com Python normalmente requer um certo nível de proficiência técnica. Mesmo havendo existam recursos e tutoriais disponíveis para aprender essas habilidades, dominar essa técnica pode exigir tempo e esforço.
API de scraping da Amazon
A Amazon fornece APIs (Application Programming Interfaces) que permitem que os desenvolvedores acessem dados do marketplace de forma estruturada. Embora essas APIs forneçam acesso estruturado a certos tipos de dados, como listagens de produtos, avaliações e informações do vendedor, elas podem não oferecer o mesmo nível de detalhe ou flexibilidade que o web-scraping. Por exemplo, as APIs podem ter taxas de extração limitadas, acesso restrito a tipos de dados específicos ou limites à disponibilidade de dados de histórico.
Multilogin para web-scraping da Amazon
O Multilogin pode ser facilmente adaptado para agilizar o processo de extração de dados de produtos da Amazon. Ele não só fornece recursos de alto desempenho, como rotação automática de endereço IP residencial e resolução de CAPTCHA para scraping de dados sem interrupções, mas também protege suas contas de serem bloqueadas por bots anti-scraping e ajuda você a automatizar suas tarefas de extração. Tudo isso faz do Multilogin a solução ideal para projetos de scraping em larga escala.
Consiga perspectivas cruciais dentro da Amazon
Como começar a usar o Multilogin para coletar dados da Amazon
Colete dados de produtos da Amazon em massa com facilidade, mantendo ao mesmo tempo suas contas a salvo de banimentos e restrições.
Cadastre-se
Inscreva-se usando um endereço de e-mail verificado
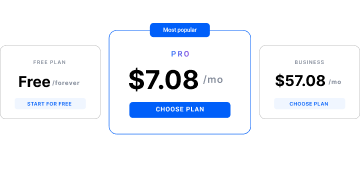
Escolha seu plano
Selecione entre vários tipos de assinatura adaptados às necessidades do seu negócio
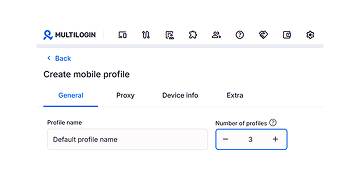
Crie um script para scraping do Amazon
Escreva um script com seus desenvolvedores ou entre em contato conosco para obter suporte personalizado
Reconhecido pelo setor,
Watch the Multilogin Demo
See how to run multiple accounts in just 2 minutes.
Watch the demo below and discover how Multilogin can streamline your workflow.