







Sessões estáveis para
cada projeto de scraping
Perfis de navegador isolados
Cookies, sessão e IP próprios em cada perfil
Proxies residenciais integrados
Incluídos em todos os planos, com geolocalização correspondente
Funciona com seus scripts
Selenium, Puppeteer, Playwright e a API
Supere Limites de Chamadas à API do Twitter
Crie diversos perfis e programe-os para coletar dados diretamente das páginas usando o navegador e os proxies do Multilogin. Tudo isso ao mesmo tempo em que você fica indetectável graças à tecnologia exclusiva de correspondência de fingerprints e ao banco de dados de IP limpo.
Colete Dados Substanciais
Extraia dados de perfis do Twitter, incluindo bios, estatísticas de seguidores, tweets anteriores, e perspectivas de engajamento. Tudo em um único ambiente de navegador colaborativo.
Colete Dados Protegidos
Contorne as barreiras à coleta de dados do Twitter para ter acesso aos dados de contas de que você precisa para fazer análises e ter perspectivas profundas.
Acelere a Coleta de Dados do Twitter
Automatize processos manuais e reduza a configuração de equipamentos necessária para coletar dados, usando um só computador mas parecendo usuários diversos em diferentes locais.
O que é o navegador Multilogin?
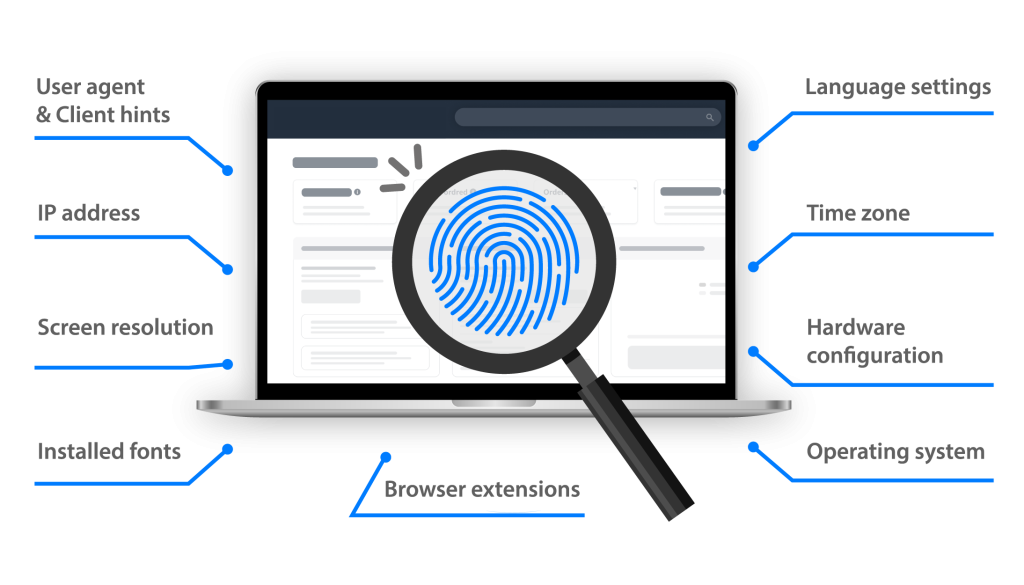
O navegador Multilogin esconde as fingerprints (“impressões digitais”) do seu computador, que incluem o histórico de navegação, cookies e detalhes de hardware. Assim, cada conta que você cria tem sua própria identidade, mesmo todas elas estando na mesma máquina. É como ter um exército de usuários anônimos, todos prontos para pegar aqueles tokens gratuitos, sem ser sinalizados!
Por que usar um navegador para coletar dados do Twitter
O Twitter tem regras rígidas contra a coleta automatizada de dados e usa várias técnicas para detectar e bloquear essas atividades. Banimentos de IP, suspensões de contas e CAPTCHAs podem interromper sua atividade e até causar perda de dados. O Multilogin ajuda você não apenas a evitar bloqueios, mas também a executar automações e ter acesso a dados restritos.
Por que escolher o Multilogin para fazer scraping no Twitter?
Extraia perspectivas cruciais do Twitter
Como começar a usar o app Multilogin para coletar dados do Twitter
Use sua liberdade para coletar quantidades enormes de dados do LinkedIn ao mesmo tempo em que mantém suas contas a salvo de banimentos e restrições
Cadastre-se
Inscreva-se usando um endereço de e-mail verificado
Escolha seu plano
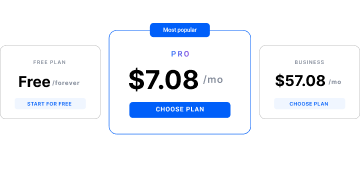
Selecione entre vários tipos de assinatura adaptados às necessidades do seu negócio
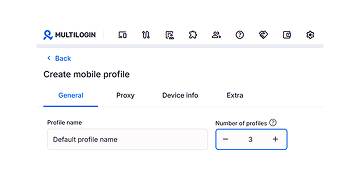
Crie um script para scraping do Twitter
Escreva um script com seus desenvolvedores ou entre em contato conosco para obter suporte personalizado
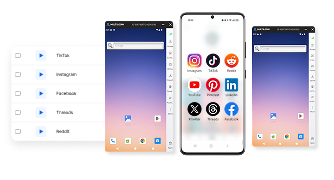
Reconhecido pelo setor,
O que é web-scraping do Twitter?
O scraping, ou data scraping, do Twitter refere-se ao processo automatizado de extração de dados do Twitter. Esses dados podem incluir tweets, perfis de usuários, hashtags, listas de seguidores e mais. Para coletar essas informações de forma rápida e eficiente, evitando a necessidade de coleta manual, a coleta de dados do Twitter implica o uso de ferramentas de software e scripts.
Apesar de apresentar potenciais desvantagens, o scraping do Twitter tem vários casos de uso legítimos e vantajosos:
- Pesquisa de mercado: as empresas podem analisar tendências, percepções dos clientes e atividades dos concorrentes.
- Pesquisa acadêmica: pesquisadores podem reunir conjuntos de dados grandes para estudar o comportamento social, padrões de comunicação e muito mais.
- Agregação de conteúdo: os veículos de notícias e as mídias podem usar o scraping para coletar e selecionar conteúdo do Twitter.
Por que a coleta de dados por scraping é ruim para o Twitter e como o X tenta evitá-la?
Embora o scraping do Twitter possa ser útil para atingir vários objetivos, como fazer pesquisa, marketing e análise de sentimentos, ele apresenta vários riscos e desafios que o Twitter trabalha ativamente para reduzir:
- Sobrecarga do servidor: o scraping automatizado pode pesar muito nos servidores do Twitter, potencialmente afetando o desempenho e a disponibilidade do site para outros usuários. Para evitar isso, o Twitter usa sistemas sofisticados de detecção de bots para identificar e bloquear atividades de scraping automatizadas, garantindo que os recursos do servidor sejam reservados para usuários de verdade.
- Problemas de privacidade: coletar dados pessoais sem o consentimento dos usuários pode levar a violações de privacidade graves e ao uso indevido de informações. O Twitter leva esse problema a sério e usa várias medidas de segurança para proteger os dados de seus usuários de serem coletados ilegalmente.
- Violação dos termos de serviço: os termos de serviço do Twitter proíbem explicitamente a coleta não autorizada de dados. Os infratores podem sofrer consequências legais e suspensão da conta. O Twitter aplica essas regras por meio de monitoramento constante e usando sistemas automatizados para detectar e prevenir atividades de scraping que violem seus termos de uso.
O que é o web-scraping do Twitter?
O web-scraping do Twitter implica extrair dados diretamente da interface do Twitter em vez de usar a API. Esse método pode ser vantajoso quando o limite de chamadas à API é restritivo demais, ou quando endpoints de dados específicos não estão disponíveis por meio da API. Contudo, fazer web-scraping exige que a pessoa lide com conteúdos dinâmicos e saiba se orientar em estruturas complexas da web.
Uso de navegadores para scraping do Twitter
Para coletar dados do Twitter de forma eficaz e segura, usar um navegadorcomo o Multilogin pode ser uma ajuda enorme. Eles ajudam a mascarar suas atividades de scraping, fazendo com que seja menos provável que suas operações sejam detectadas e bloqueadas pelo Twitter.
Vamos dar uma olhada em alguns dos recursos mais importantes para acelerar seus processos de coleta de dados e mantê-los bem protegidos.
Integração de proxies
O Multilogin oferece seu próprio proxy residencial, o Multilogin Proxy, que ajuda a mascarar seu endereço de IP e sua geolocalização. Isso é crucial para evitar ser detectado e para contornar restrições regionais. Integrando proxies, você consegue distribuir suas solicitações por vários IPs, reduzindo o risco de ser marcado pelos sistemas de segurança do Twitter.
Automação de ações do navegador
Com o Multilogin, você consegue automatizar tarefas repetitivas, preenchimento de formulários e coleta de dados para espaços colaborativos específicos, como Excel, Google ou Notion. Isso tudo pode ser feito graças à nossa documentação detalhada para API e a ferramentas integradas como Selenium, Playwright e Puppeteer. Como os navegadores são projetados para imitar o comportamento de seres humanos, executar suas automações em um navegador desses reduz a probabilidade de você ser detectado. Você pode criar scripts para as navegação no Twitter, interagir com a interface e coletar dados sem problemas.
Recursos de trabalho em equipe
O Multilogin também oferece recursos de peso para trabalho em grupo. Isso permite que vários membros da equipe trabalhem em projetos de scraping simultaneamente, compartilhando perfis de navegador, notas importantes e configurações com toda segurança. Isso é particularmente útil para operações de scraping em larga escala, nas quais é preciso que os esforços sejam coordenados.
Uso de Python no scraping do Twitter
Python é uma das linguagens de programação mais populares para web-scraping, por causa da simplicidade dela e da disponibilidade de bibliotecas de peso. Ferramentas como BeautifulSoup, Scrapy e Tweepy facilitam a extração de dados do Twitter. Eis uma visão geral rápida de como você pode usar Python para scraping do Twitter:
- Uso de Tweepy: Tweepy é uma biblioteca Python que permite que você interaja com a API do Twitter. Você pode usá-la para coletar tweets, dados do usuário e outras informações relevantes.
- BeautifulSoup e Scrapy: Essas bibliotecas podem ser usadas para analisar documentos HTML e XML, o que é útil para coletar dados diretamente de páginas do Twitter.
- Selenium: Selenium é uma ferramenta de automação de navegador que pode ser usada para interagir com a interface da web do Twitter, especialmente para coletar conteúdo dinâmico que requer interação do usuário.
Watch the Multilogin Demo
See how to run multiple accounts in just 2 minutes.
Watch the demo below and discover how Multilogin can streamline your workflow.